
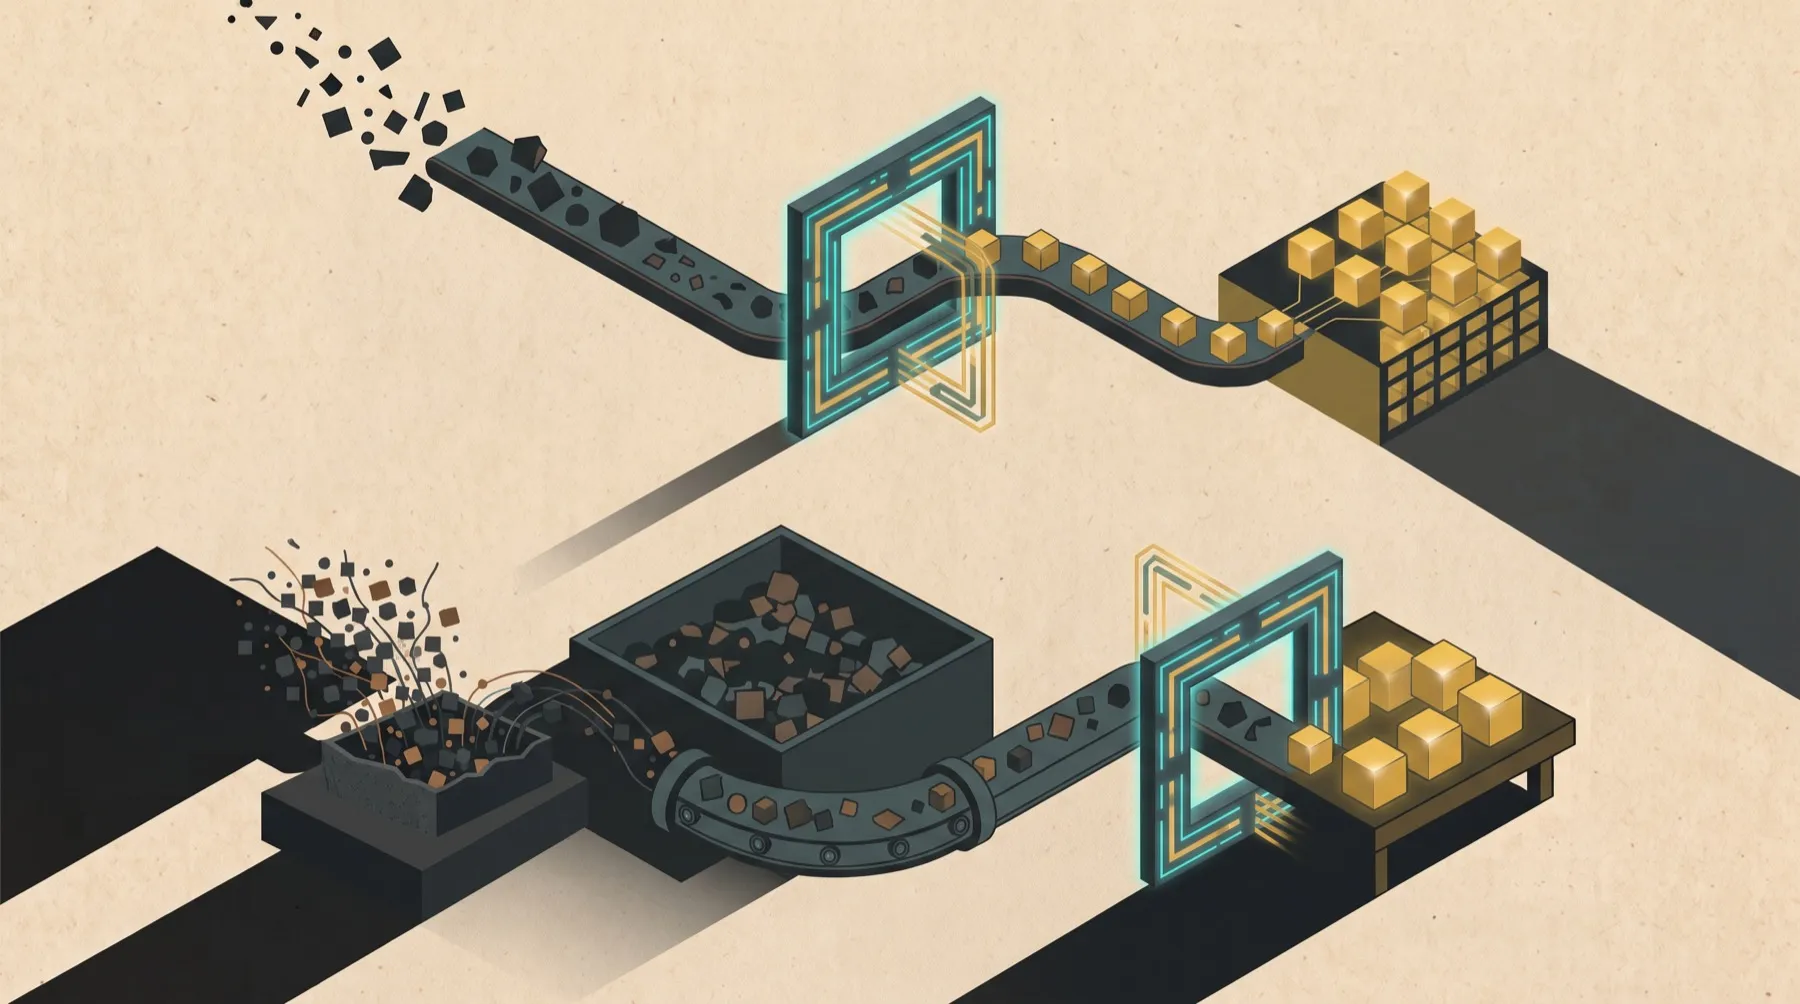
Elke keer dat je data van een bronsysteem naar je datawarehouse brengt, doorloop je drie stappen, extraheren, transformeren en laden. ETL en ELT zijn de twee volgordes waarin je dat kan doen, en die volgorde bepaalt hoeveel je achteraf nog met je data kan.
Wat is het verschil tussen ETL en ELT?
Bij ETL extraheer je data uit de bron, transformeer je die meteen naar de vorm die je nodig hebt, en laad je pas het eindresultaat in je datawarehouse. Bij ELT laad je de data eerst ruw in, precies zoals die uit de bron komt, en transformeer je pas daarna, in het datawarehouse zelf.
ETL was decennialang de standaard manier van werken. De afgelopen tien jaar is dat verschoven naar ELT.
Waarom was ETL zo lang de standaard?
Opslag was vroeger duur. Wilde je data bijhouden, dan dacht je vooraf goed na over wat je precies ging bewaren, want elke extra megabyte kostte geld. Transformeren voordat je laadt, houdt je datawarehouse compact. Je bewaart dan alleen het eindresultaat, niet de ruwe bronnen eronder.
Die beperking is grotendeels verdwenen. Clouddataopslag zoals Amazon S3 kostte in 2006 nog zo’n 15 dollarcent per gigabyte per maand. Nu is dat nog maar een paar cent. Platforms zoals BigQuery, Snowflake en Databricks zijn gebouwd om grote hoeveelheden ruwe data goedkoop op te slaan. Vooraf transformeren om ruimte te besparen heeft weinig zin meer als opslag toch al nauwelijks kost.
Waarom is ELT beter dan ETL?
ELT is beter dan ETL omdat je de ruwe databronnen bewaart in plaats van alleen het eindresultaat van een berekening. Verandert je rapportagebehoefte later, dan kan je daarop terugvallen zonder dat je opnieuw bij het bronsysteem hoeft aan te kloppen, want veel bronsystemen hebben die geschiedenis dan allang niet meer.
Neem de status van een klant in je CRM, bijvoorbeeld lead, prospect of klant. Dat veld wordt in het bronsysteem overschreven zodra de status verandert, dus het bronsysteem zelf houdt geen geschiedenis bij.
Bij ETL bepaal je vooraf welke berekening je nodig hebt, bijvoorbeeld de gemiddelde doorlooptijd van lead naar klant, en sla je alleen dat resultaat op. Wil je een half jaar later een nieuwe analyse doen, bijvoorbeeld hoeveel leads eerst via de tussenstap prospect gingen voordat ze klant werden, dan kan dat niet meer.
Bij ELT leg je elke statuswijziging ruw vast in je bronzen laag, op het moment dat die binnenkomt, los van wat je er op dat moment mee gaat doen. Verandert je rapportagebehoefte later, dan bouw je een nieuwe transformatie op de geschiedenis die je al hebt liggen.
Dit is dezelfde reden waarom we bij het inrichten van een datawarehouse altijd aanraden om met een bronzen laag te beginnen. Hoe meer je transformeert voordat je iets opslaat, hoe minder je achteraf nog kan terugvinden.
Is ETL dan nooit meer de juiste keuze?
Niet helemaal. Sommige data wil je juist niet ruw in je datawarehouse hebben staan. Persoonsgegevens die vanwege privacywetgeving eerst gepseudonimiseerd moeten worden, of velden die alleen gemaskeerd verder mogen, transformeer je al voor het laden.
ETL en ELT sluiten elkaar daarmee niet uit. In de praktijk kies je per databron wat nodig is, met ELT als uitgangspunt en ETL voor de uitzonderingen waar dat niet kan.
Begin bij de ruwe data
Welke keuze je per databron ook maakt, de kern blijft hetzelfde. Begin met een plek waar je ruwe data veilig en volledig staat, en bouw je transformaties daarbovenop. Dat is het fundament waarmee rapportages, dashboards en AI-toepassingen betrouwbaar blijven werken, ook als er een keer iets misgaat.